Ogni team che crea agenti di AI scopre una verità fondamentale: senza le informazioni giuste, un agente non può rispondere in modo affidabile a una domanda o intraprendere l'azione corretta.
Con l'aumentare delle finestre di contesto delle LLM, è stato allettante presumere che fornire a un agente più informazioni ne avrebbe migliorato l'accuratezza. In pratica, un maggiore contesto rende gli agenti più lenti e costosi, riducendo al contempo l'accuratezza seppellendo segnali utili tra informazioni irrilevanti.
Ecco perché il successo di un agente ora si basa sulla context engineering (ingegneria del contesto), la pratica di selezionare, organizzare e presentare a un agente solo le informazioni di cui ha bisogno per completare un compito in modo efficace.
E il fulcro di tutto questo lavoro avviene nel recupero. La domanda non è quanto puoi inserire nel contesto. È quali dieci cose su dieci milioni scegli.
La piattaforma di dati intelligente di MongoDB unisce i migliori modelli di embedding e reranking di Voyage AI con una piattaforma per la creazione, il funzionamento e l'evoluzione di sistemi di recupero complessi. Con l’introduzione di oggi della serie Rerank 3 e di $rerank nell’aggregation pipeline, gli sviluppatori possono migliorare la qualità e l’ordine del contesto recuperato nello stesso sistema in cui risiedono i loro dati operativi. Il risultato è un modo più semplice per creare sistemi di recupero che forniscono agli agenti il contesto necessario per agire.
Lo stack di recupero
Un recupero efficace richiede un sistema coordinato per trovare informazioni utili, determinare cosa è più importante e consegnarle in modo efficiente all'agente.
La strategia determina come il sistema cerca i suoi dati. La ricerca per parole chiave può far emergere termini esatti, mentre la ricerca vettoriale trova contenuti concettualmente simili. Filtri e approcci ibridi aggiungono precisione e controllo, assicurando che venga recuperato solo il contesto rilevante.
I modelli determinano che aspetto ha la pertinenza per i tuoi dati. Un modello di embedding più forte aiuta la ricerca vettoriale a identificare i candidati migliori comprendendo la somiglianza concettuale e l'intento della query. Un reranker consente al recupero di prima fase di ottimizzare il richiamo, quindi separa le corrispondenze più forti dal set di candidati.
Il motore giusto riunisce queste tecnologie disparate, mantenendo i dati aggiornati e le query efficienti mentre il sistema è in esecuzione in produzione.
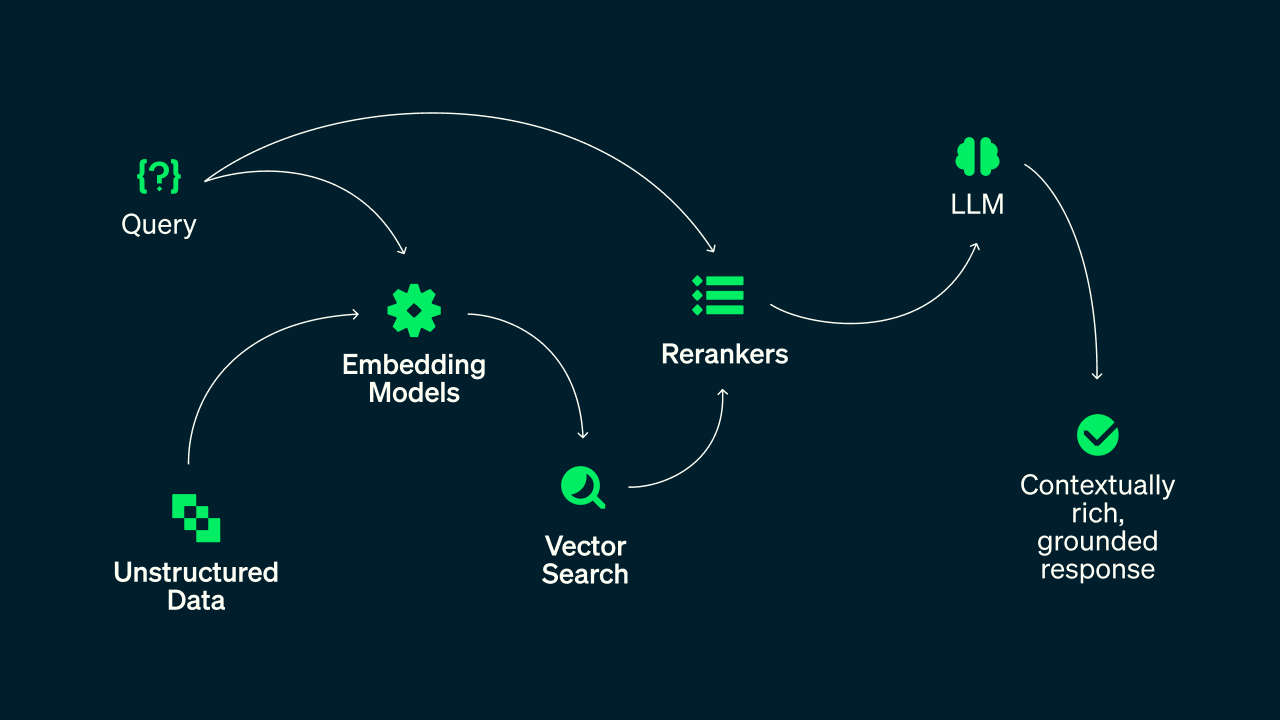
Senza una piattaforma unificata per managed il recupero, il lavoro diventa rapidamente complicato. Potresti utilizzare un provider per gli embedding, un altro per il reranking e più fornitori di database per i tuoi dati operativi, di ricerca e vettoriali. Ciò significa più integrazioni, lavori di sincronizzazione e chiamate API da mantenere. Può anche creare problemi silenziosi: l'indice di ricerca vettoriale potrebbe utilizzare una versione del modello di embedding mentre l'applicazione ne utilizza un'altra, danneggiando la pertinenza senza causare un errore esplicito.
Figura 1. La pipeline di recupero disconnessa.
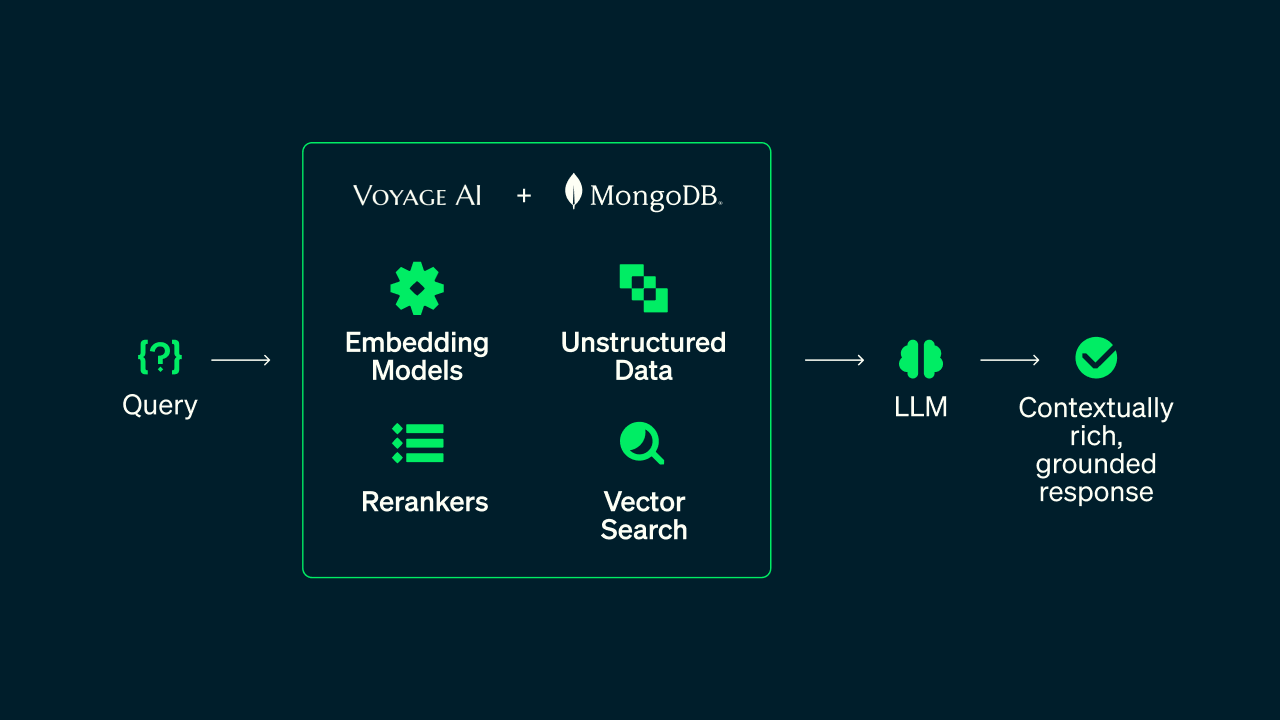
MongoDB riunisce questi elementi in un'unica piattaforma. Supporta le strategie di ricerca di cui gli sviluppatori hanno bisogno, inclusi recupero di testo, vettoriale, ibrido e filtrato, e le abbina ai modelli di embedding e ai reranker all'avanguardia di Voyage AI. Automated Embedding mantiene i vettori sincronizzati man mano che i dati cambiano, mentre il native rerank consente agli sviluppatori di perfezionare i risultati nella stessa aggregation pipeline. Il risultato è un'unica query in grado di cercare dati operativi, applicare la giusta strategia di recupero, riordinare i risultati e restituire il contesto necessario a un agente.
Figura 2. La pipeline di recupero unificata basata su MongoDB.
I modelli
L'introduzione odierna di rerank-3 e rerank-3-lite offre una maggiore precisione in tutte le attività, con i maggiori incrementi su documenti lunghi e codice. rerank-3 supera Cohere Rerank v4.0 Pro del 2,72% e Qwen3-Reranker-8B del 3,02% complessivamente. Se utilizzi rerank-2.5 oggi, l'aggiornamento è una modifica del nome del modello su una riga. Stessa API, stesso prezzo.
rerank-3 migliora la pertinenza indipendentemente dal modo in cui viene recuperato il set di candidati iniziale. La tabella seguente mostra l'aumento di accuratezza tra diversi metodi di recupero comuni nella prima fase.
Tabella 1. Confronti di accuratezza.
Il motore
MongoDB è il motore di recupero operativo alla base di tutto questo e ogni strategia viene eseguita in modo nativo sugli stessi dati su cui la tua applicazione scrive già. La ricerca lessicale rileva identificatori, codici di errore e nomi esatti dei prodotti. La ricerca vettoriale rileva concetti e parafrasi. Il recupero ibrido li combina e i filtri dei metadati mantengono l'insieme dei candidati abbastanza piccolo da rimanere veloce. Nulla di tutto ciò richiede lo spostamento dei dati in un sistema separato o il mantenimento sincronizzato di due copie.
Automated Embedding gestisce la parte che solitamente crea problemi. I vettori vengono generati e aggiornati a livello di campo in tempo quasi reale, con il consumo di token e l'integrità dell'indice visibili nell'IU di Atlas. Non c'è un lavoro di embedding da gestire e nessuna possibilità di discrepanza tra la versione del modello su cui è stato creato l'indice e la versione del modello su cui vengono eseguite le query.
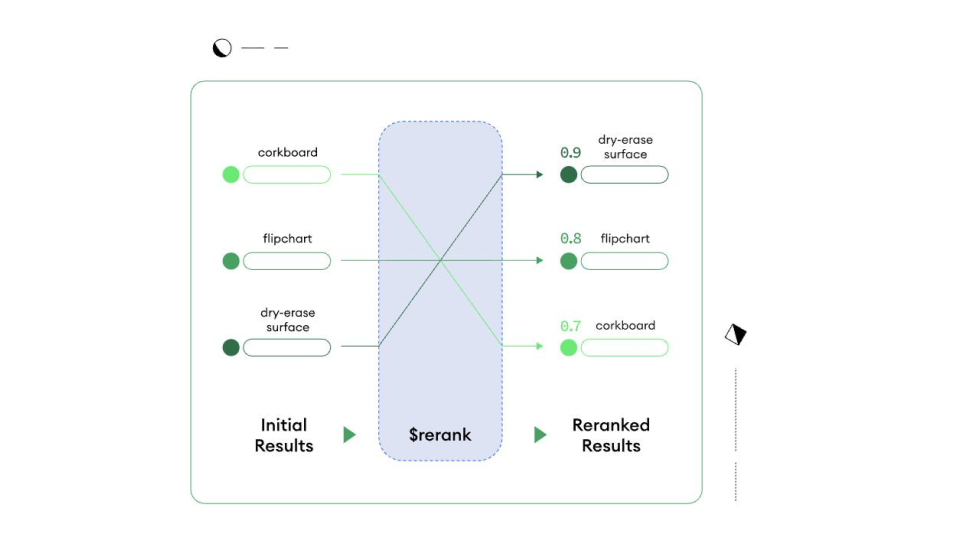
$rerank, disponibile oggi, aggiunge la fase di ordinamento finale a quella stessa pipeline. Si tratta di una fase senza indice che può prendere qualsiasi impostare di candidati prodotto dalla fase precedente e rivalutarlo con rerank-3 o rerank-3-lite. Nessun fornitore separato, nessuna chiamata API esterna, nessun passaggio di riassemblaggio nel codice dell'applicazione: è importante quando un agente effettua diverse chiamate di recupero per attività invece di una.
Figura 3. $rerank in azione.
Gravità: che aspetto ha quando funziona
Gravity sta costruendo una rete pubblicitaria che ottimizza la pubblicità per l'era dell'AI. In quel contesto, la pertinenza non è un elemento aggiuntivo: è il prodotto. Il loro problema non era il recall. I modelli di embedding e reranking precedenti restituivano punteggi di pertinenza troppo ravvicinati tra loro, quindi Gravity non riusciva a separare in modo affidabile una corrispondenza forte da una debole.
"La cosa più importante che abbiamo riscontrato nei nostri benchmark è stata la capacità di Voyage AI di essere discriminatorio nei confronti dei candidati che non sono una buona corrispondenza e di promuovere davvero quelli che sono una buona corrispondenza", ha affermato Leo Martinez, co-fondatore e CTO di Gravity. Il passaggio a Voyage AI ha ridotto la Latency di recupero di circa il 50% e ha migliorato l'accuratezza con l'aumento del volume delle richieste.
Colmare The Gap
La qualità del recupero è un layer di ciò che MongoDB sta costruendo su cui gli agenti possono essere eseguiti. MongoDB 9.0 e Atlas Infinite rappresentano il layer di prestazioni e scalare elastico, che assorbe il traffico bursty creato dai carichi di lavoro agentici. Atlas Agent motore è il layer di memoria e governance, che offre agli agenti contesto e guardrail persistenti durante le sessioni; il recupero è basato su Atlas Vector Search e Voyage AI. Un agente decide cosa recuperare prima di decidere cosa fare. Un'infrastruttura più veloce rispetto a un recupero scadente significa solo agire prima sulla cosa sbagliata.
Ottenere il recupero corretto non richiede più un'architettura complessa. Automated Embedding gestisce gli embedding, $rerank gestisce l'ordinamento ed entrambi vengono eseguiti sui dati operativi direttamente in MongoDB. I modelli sono disponibili anche come standalone tramite l'API di Atlas Embedding e Reranking.